Yapay zeka ve dijital çağda verilerimizin güvenliği konusunda daha hassas olmamız gerektiğini, Navier-Stokes denklemleri üzerinde yaşanan drama, bir kez daha gözler önüne serdi.
Geçtiğimiz günlerde matematik ve yapay zeka camiasını bir süre meşgul eden Navier-Stokes denklemleri üzerinde yaşanan drama, dijital çağda verilerimizin güvenliği konusunda dikkat etmemiz gerekenleri bir kez daha gözler önüne serdi.
Navier-Stokes denklemlerini basitçe açıklamak gerekirse durum, matematikçiler Levent Alpöğe ve Tristan Buckmaster’ın sıvı ve hava gibi akışkanların hareketlerini inceleyen bu denklemler üzerine çalışmasına dayanıyor. İkili, bu süreçte OpenAI’ın kod yazabilen yapay zeka ajanı Codex’ten yararlandı.
Buckmaster ve Alpöğe projelerini yayımlamaya hazırlanırken, OpenAI tam da bu süreçte yapay zeka ajanları sayesinde Navier-Stokes denklemlerini çözdüğünü duyurdu. İş bu noktadan sonra ilginçleşiyor. Çünkü Buckmaster’ın iddiasına göre OpenAI, denklem çözülürken kullanılan yöntemleri onların Codex ile yaptığı sohbetlerden çekmişti. OpenAI ise bu iddiayı reddetti. Ancak modelin anonimleştirilmiş sohbet verileriyle eğitilmiş olabileceğini kabul etti.

Navier-Stokes denklemlerine dair OpenAi’ın paylaşımı.
Bu noktada, bireysel kullanıcı olarak verilerimiz konusunda bazı büyük riskler göz önüne seriliyor. Bizim paylaştığımız veriler, görseller veya videolar yapay zekanın eğitim sürecinde kullanılıyor mu? Eğer kullanılıyorsa, bu durum gelecekte ne gibi problemlere yol açabilir?
Neden bizim verilerimize ihtiyaçları var?
Modern yapay zeka, yapısı gereği doğuştan gelen bir bilgiye sahip değil, bu nedenle bizim verilerimize ihtiyaç duyar. İnsanların ürettiği veriler yapay zekanın dünyayı, dili, görselleri ve mantığı anlamlandırmasını sağlıyor. Bu aslında bir çocuğun hayatı deneyim kazandıkça öğrenmesine benziyor. Çocuklar arabanın veya böceğin ne olduğunu ebeveynlerine sorarak ya da etrafındaki tepkileri gözlemleyerek öğrenir. Yapay zeka da bize vermiş olduğu cevapları oluşturabilmek için milyonlarca veriyi kullanır ve en sonunda bir çıktı elde eder. Peki bu verileri nasıl sağlıyoruz?
Yapay zeka pasif, aktif ve kullanıcı geri bildirimi olmak üzere üç biçimde veri elde ediyor. Pasif veri toplama, kamuya açık tüm içeriklerin yapay zeka tarafından taranmasıyla gerçekleşiyor. Sosyal medya hesaplarımızda herkese açık paylaştığımız gönderiler veya yazdığımız blog yazıları bu kapsama giriyor.
Aktif veri toplamada ise bu eğitimi farkında olmadan kendi elimizle yapıyoruz. CAPTCHA gibi “robot değilim” testlerinde seçtiğimiz görseller veya çözdüğümüz bulmacalarla sistemlere aslında ‘’bak bu bisiklet’’ veya ‘’bak bu insan’’ diyerek modelleri eğitmiş oluruz.
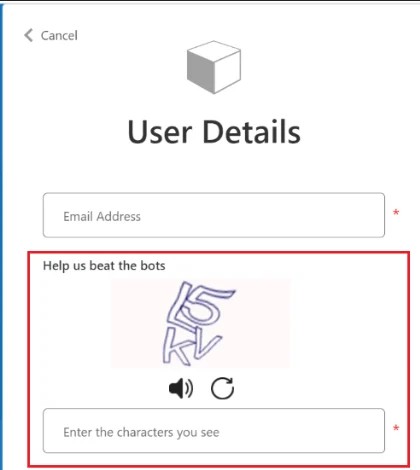
reCAPTCHA robot değilim testi örneği.
Kullanıcı geri bildirimi ise aslında bugünlerde veri güvenliği konusunda en çok dikkat çeken veri metotlarından biri. Yapay zeka şirketlerinin bizlere sunduğu yapay zeka ajanlarını kullanırken verdiğimiz geri bildirimler bir sonraki cevabı etkiler. ‘’Evet bu doğru’’ ya da ‘’hayır bunu istememiştim’’ gibi geri bildirimler yapay zeka ile yaptığımız sohbetlerde paylaştığımız bilgilerin ışığında gerçekleşir.
Yapay zekaya verilen insan geri bildirim örneği.
Sonuç olarak, internette kamusal varlığımız, forumlardaki tartışmalarımız, çözdüğümüz güvenlik testleri ve bizzat yapay zeka araçlarıyla olan günlük etkileşimlerimiz yapay zekanın eğitilmesine doğrudan katkıda bulunuyor.
Ücretsiz yapay zeka araçlarının maliyeti verilerimiz
Dijitalleşmeyle birlikte ücretsiz bir şekilde kullandığımız birçok araçtan biri de yapay zeka araçları. Peki yapay zeka biz ve ürettiğimiz veriler olmadan varlığını sürdürebilir mi?
Aslında “ücretsiz” sunulan bu araçların gizli bir maliyeti var: verilerimiz. Bu hizmetlerin bedelini cebimizden çıkan parayla değil; dijital ayak izimiz, kişisel tercihlerimiz ve biyometrik verilerimizle ödüyoruz. Bunun en somut örneklerinden biri sosyal medyada popülerleşen ve OpenAI’ın başlattığı “80’ler ve 90’lar yıllığı” akımı. O yıllarda nasıl görüneceğimizi merak edip fotoğraflarımızı yapay zeka araçlarına kendi ellerimizle sunduk. Ancak bunu yaparken hesaba katmadığımız bir nokta vardı: paylaştığımız fotoğraflarımız büyük dil modellerinin eğitim süreçlerinde veri olarak kullanıldı.
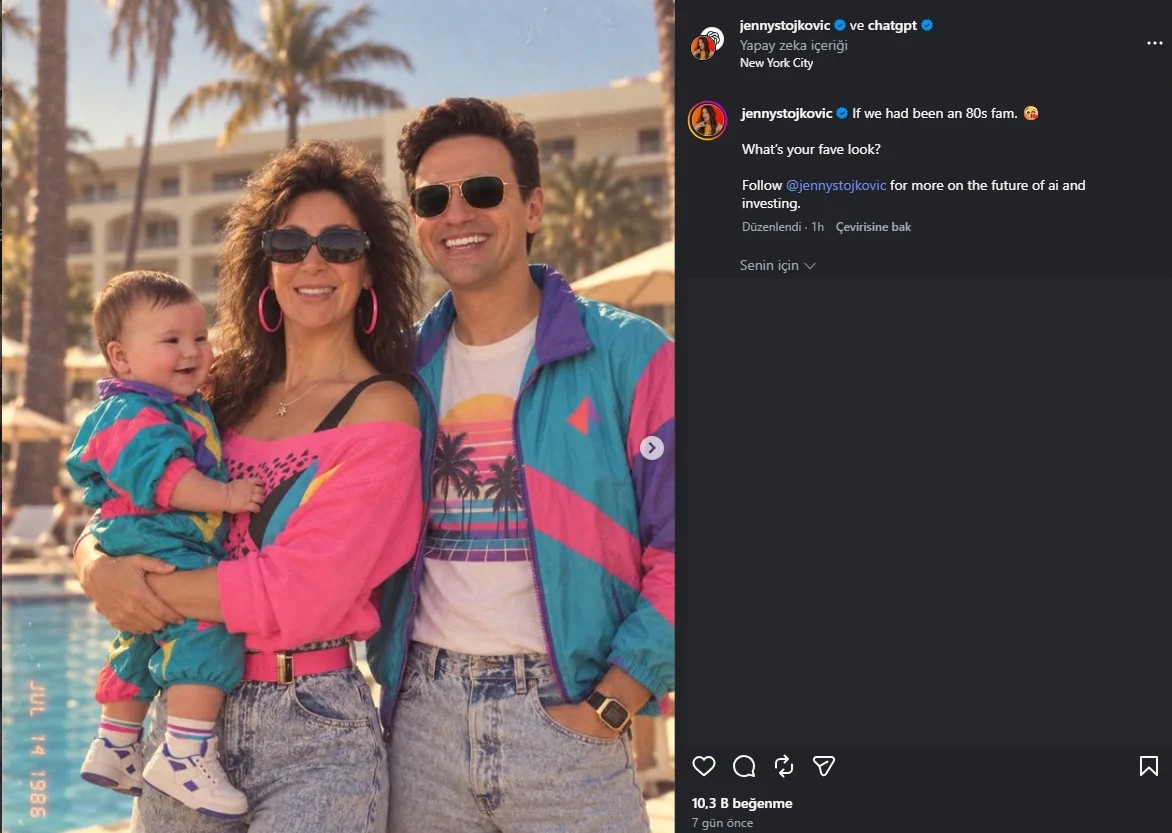
OpenAI 80’ler 90’lar yıllığı akımı.
Risk ne?
Yapay zekayla paylaştığımız fotoğraflar, görsel ve video üretme gibi süreçlerde model olarak kullanılmamıza sebep olabilir. Bu araçların çizim yeteneğini, yüklediğimiz görsellerle biz geliştiriyoruz. Ancak durum sadece bununla sınırlı değil. Yapay zeka kullanıcı profillemesi yaparak bizi üçüncü taraf şirketler için ticari bir değere dönüştürüyor.
Ses ve yüz gibi biyometrik verilerimizin veri tabanlarında saklanması, bizi gelecekte “yalnızca kişiselleştirilmiş reklamların hedefi haline getirmekle kalmayıp güvenliğimizi ve mahremiyetimizi de riske atabilir. Sorgusuz sualsiz paylaştığımız bu veriler yüzünden gelecekte karşı karşıya kalabileceğimiz üç temel risk var:
- Kimlik hırsızlığı ve biyometrik klonlama: Gelecekte ses ve yüz gibi biyometrik verilerimiz kolayca klonlanabilir hale gelebilir. Bu durum bankacılık işlemlerinden kişisel iletişimimize kadar pek çok alanda kullanılan "biyometrik doğrulama" sistemlerinin güvenilirliğini ihlal edebilir.
- Deepfake ve dezenformasyon: “80’lerde nasıl görünürdüm” merakıyla başlayan süreç gelecekte yüzümüzün ve sesimizin yapay zeka tarafından üretilmiş her türlü içerikte kullanılmasıyla son bulabilir. Sesimiz ve yüzümüz ile pornografik içerikler, dolandırıcılık ya da siyasi manipülasyon içerikleri üretilebilir.
- Kapsamlı gözetim ve algoritmik ayrımcılık: Toplanan veriler, gelecekte dijital profillerimizin oluşturulmasına yol açabilir. Bu profiller doğrultusunda yapay zeka, iş başvurularında kimin işe alınacağını belirleyebilir ya da kredi başvurularında kredi notumuzu doğrudan etkileyebilir.
Kısacası, eğlenmek ve vakit geçirmek amacıyla yapay zeka araçlarıyla paylaştığımız kişisel bilgiler ve biyometrik veriler, gelecekte dolandırıcılık, sistem açıkları ve uygunsuz içeriklerin üretilmesinde kullanılabilir. Örneğin, yüzünüzle eğitilmiş bir yapay zeka, başka bir kullanıcının komutuyla oluşturulan bir görselde sizin yüzünüzü kullanabilir.
Bu riski nasıl minimuma indiririz?
Bu riskler ile karşı karşıya kalmak her ne kadar göz korkutucu görünse de korunmak aslında imkansız değil. Öncelikle, eğlence amaçlı yapay zeka araçlarını kullanırken ve biyometrik verilerimizi paylaşırken iki kere düşünmeliyiz. Bir yapay zeka ajanına hassas kişisel bilgilerimizi sunmak yerine sadece sistemin çalışması için gereken asgari bilgiyi vermeliyiz.
Gizlilik sözleşmelerini okuma alışkanlığı kazanmalıyız. Uygulamaların "kullanım koşulları" metinlerinde verilerimizin üçüncü taraflarla paylaşılıp paylaşılmadığını ve büyük dil modellerinin eğitim sürecinde kullanılıp kullanılmadığını kontrol etmeli ve buna göre onay vermeliyiz.
Son olarak ise devletlerin yapacağı düzenlemeler ve veri sömürüsünü kısıtlayan yasalar bireysel veri gizliliğini korumada temel yapı taşlarından biri olacak. Avrupa Birliği'nin kabul ettiği Yapay Zeka Yasası gibi düzenlemeler emsal alınmalı, vatandaşlara şirketlerden “unutulma hakkı” kapsamında verilerinin silinmesini talep etme hakkı tanınmalı.